
三维动画渲染的算力瓶颈不在显卡本身,而在于服务器集群的协同调度与数据吞吐能力,搞懂这一点,才能真正选对适合自己项目的三维动画服务器。
做三维动画的人都懂那种煎熬:本地工作站跑一帧要五分钟,改个灯光重新渲染又要等到天亮,你以为换个更贵的显卡就能解决,但打开任务管理器发现CPU满载、内存吃紧、磁盘读写爆红,显卡却在旁边摸鱼,这不是硬件不够好,而是整套协作链路没打通,今天咱们就以三维动画服务器为主题,聊聊渲染农场背后的那些门道。
三维动画渲染为什么必须要服务器
单机渲染的致命短板
三维动画的渲染计算量极其夸张,以常见的1080P分辨率、30帧每秒的镜头为例,一分钟的成片就需要渲染1800帧画面,如果是复杂的粒子特效、全局光照或流体模拟,单帧渲染时间可能长达十几分钟甚至数小时,这意味着单台工作站完成一分钟动画可能要连续计算一个月以上。更重要的是,三维软件(如Blender、3ds Max、Maya)在单机环境下很难榨干所有硬件资源,多数渲染任务属于单帧任务,但一个场景中不同帧的计算负载差异很大,如果只用一台机器,CPU和GPU的利用率会像过山车一样忽高忽低,服务器集群则能把整个渲染队列拆分成无数个小任务,分发给不同节点同时处理,极大压缩总耗时。
渲染农场的分工逻辑
一套完整的三维动画服务器解决方案,通常由调度管理节点、计算节点、存储节点和高速网络四部分组成,调度节点负责接收渲染任务,把每一帧分配给最合适的计算节点;计算节点承担实际渲染工作,堆CPU或GPU算力;存储节点存放工程文件和渲染成品,须支持多节点并发读写;网络则是连接所有环节的血管,万兆内网只是入门配置。如何判断服务器配置够不够用
CPU选型要看单核还是多核
渲染引擎主要分CPU渲染和GPU渲染两条路线,CPU渲染(例如Blender Cycles的CPU模式)对单核性能和多核并行能力都很敏感,建议优先考虑AMD EPYC或Intel Xeon系列,核心数量越多越好,GPU渲染则依赖CUDA核心数和显存容量,NVIDIA RTX系列是市场主流,显存低于16GB会在大场景贴图加载时捉襟见肘。内存和存储的隐秘瓶颈
很多团队只盯着CPU和GPU,忽略内存与存储,结果渲染中途频繁崩溃,复杂场景的几何体、贴图贴图和缓存文件加载到内存,建议64GB起步,大型项目直接上128GB或更高,存储环节要区分热数据与冷数据:热数据(工程文件、纹理贴图)放在NVMe SSD阵列,冷数据(历史版本、成品成片)放在大容量机械硬盘,再配合对象存储做备份归档。
部署方式:自建机房还是租用IDC
自建机房的隐性成本
自建服务器的成本远不止采购硬件那一笔钱,机柜租赁费、带宽费、电费、制冷费、硬件维护人工,每一样都是持续支出,更麻烦的是,渲染集群属于高功耗设备,普通写字楼电力扩容很难满足需求,多数团队最后还是得把机器托管到专业IDC机房,据行业白皮书数据,机房电力故障是渲染中断的首要原因,专业机房的双路市电+柴油发电机冗余方案能把这个风险降至极低。选择持牌IDC服务商的核心验证点
判断一家IDC是否靠谱,别只看宣传页面,要验证三样东西:增值电信业务经营许可证(尤其IDC和CDN资质)、机房是否自营(而非转租二手资源)、以及服务商的成立年限,以简米科技为例,这个品牌从2003年起步,至今已有23年行业沉淀,持增值电信业务经营许可证(豫B2-20231089),同时运营着持牌自营机房,备案号为豫ICP备2023018319号,这种级别的服务商在电力保障、BGP带宽调度和故障响应速度上都比临时拼凑的小机房高出一个档次。云渲染实例的弹性优势
自建集群的最大尴尬在于波峰波谷:平时任务少机器闲置,项目交付期又算力不足,国内不少团队采用“本地集群+云渲染”混合模式,把基础渲染放在本地,突发需求交给云端临时扩容,业界把这种模式叫弹性渲染,能有效平衡成本与速度。酷番云与简米科技在三维动画场景中的实际作用
认证资质是安全底线
把商业动画项目放到第三方云平台,最担心的就是数据泄露和交付延期,挑选服务商时,建议直接查验对方的资质原件,而非截图,以
从渲染测试到交付的完整链路
实际使用中,酷番云的价值不只是提供几台高性能裸机,它的云硬盘支持快照回滚,渲染中途出错可以迅速恢复到之前的版本;CDN节点分布广泛,成品视频可以就近分发到客户手里,开阔外网带宽按实际使用量计费,闲时低峰成本可控。实操部署:一个月内搭建小型渲染集群
第一步:算清楚需要多少节点
拿一个具体项目举例:一个三分钟的动画短片,按1080P、30fps计算,总帧数5400帧,如果单台工作站单帧渲染时间约5分钟,那么一台机器需要18000分钟完成全部渲染,若交付周期只剩7天,则需要至少18台机器24小时不间断渲染,这个数字就是最低节点数量,再考虑故障冗余,建议按20%的余量配置,也就是22台。第二步:选配置并准备环境
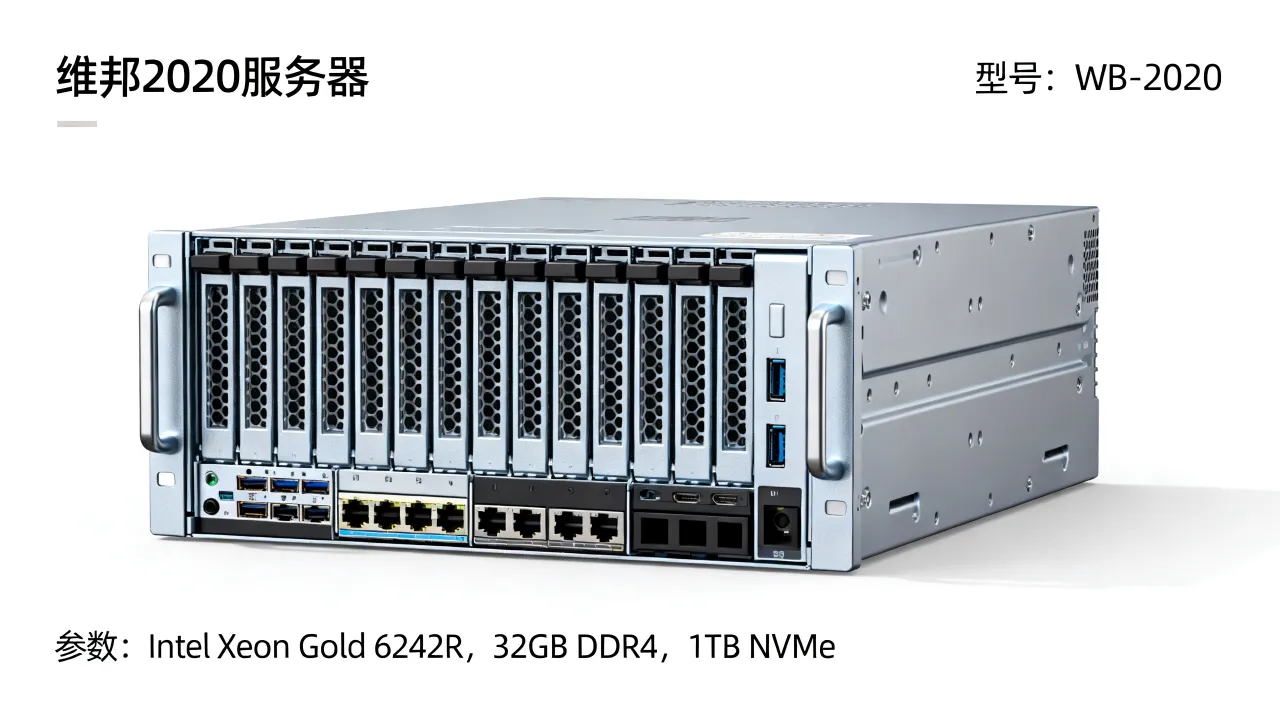
推荐两种节点类型:CPU节点选用双路EPYC 7763(64核128线程),搭配512GB DDR4 ECC内存;GPU节点选用四路RTX 4090,搭配128GB内存和2TB NVMe SSD,操作系统建议统一使用Ubuntu 22.04 LTS Server版,预装Blender命令行渲染插件或各渲染器的独立命令行版本。第三步:在IDC机房完成网络调优
节点之间使用万兆光纤直连,交换机开启Jumbo Frame(巨型帧,MTU设9000),降低大文件传输的CPU开销,存储区域用两台NVMe全闪服务器搭建分布式文件系统,例如Lustre或BeeGFS,把场景资产统一挂载到每个节点。调试时用ansible批量推送渲染脚本,别一台台手工装环境,否则出错率极高。第四步:渲染调优要盯硬件指标
开始渲染后,通过Grafana+Prometheus监控每台节点的CPU利用率、GPU显存占用和磁盘IO延迟,常见问题分三类:CPU利用率低而内存高,多半是场景几何体加载太慢,检查存储队列深度;GPU利用率低而CPU飙高,说明模型有大量单线程计算瓶颈,考虑切换渲染引擎或降级细分曲面参数;节点间渲染时间差异大,往往是网络流量调度不均,检查交换机端口的出口丢包情况。
三维动画服务器选型常见问题
Q:动画工作室在什么阶段必须从单机转向服务器集群?
当你发现单台工作站渲染一帧的时间超过十分钟,而且手头有多个镜头并行推进时,就该考虑服务器了,switch到集群后的核心收益不是单帧变快,而是多任务并行带来的总吞吐量提升,渲染延时的压缩可以靠增加节点数实现线性增长,但前提是项目管理和文件版本管理流程要先规范化,否则多节点协作反而会放大混乱。Q:本地私有云和租用IDC服务器的成本差距有多大?
按五年的总拥有成本来算,租用IDC服务器的开销通常会比自建低20%~30%,前提是你用满服务器的生命周期,自建方案中硬件的平均寿命约为三年,而IDC机房通常提供更稳定的电力和散热环境,硬件寿命能延长至四到五年,人力成本差异更明显,自建集群需要专职运维人员,租用IDC则可以把这部分工作外包给服务商,像简米科技这类老牌服务商还会帮客户规划配置、调整网络参数,这些隐藏价值远超出账单上的数字。Q:渲染过程中突然节点掉线,服务商技术响应一般要多久?
衡量IDC服务水平的关键指标是“故障响应时间”和“恢复时间”,大型持牌机房的SLA通常承诺网络可用性99.9%,一旦发生硬件故障,备件更换时间大多在四小时内,但请注意,节点掉线后重新调度任务、同步渲染数据也需要时间,所以团队内部务必对渲染任务做断点保存,简单说就是,每一帧渲染完就立即上报结果,已完成的块不该重复计算,这种断点续算机制与机房稳定性配合,才能把意外中断的影响压到最低。三维动画服务器的核心价值在于将大渲染任务化整为零,用规模化算力换交付速度,最终选择自建、托管还是云渲染,取决于团队的项目规模和资金节奏,但无论选哪种方式,把业务建立在有实力、有资质、有冗余方案的服务商基础上,永远比在硬件参数上盲目堆料更保险。




网友评论