
GPU服务器运维的核心在于把“电、热、驱动、链路”这四件事盯到位,日常巡检比事后救火更重要。
机房里的GPU卡不像普通CPU服务器那样“皮实”,它对供电质量、散热环境、驱动版本以及PCIe链路的稳定性极其敏感,不少团队第一年接触GPU服务器,经常被莫名其妙的“掉卡”“算力下降”折腾到半夜,只要摸清运维的关键路径,大部分问题都能提前预防。
GPU服务器运维的日常:从“救火”到“防火”
有人觉得运维就是修机器,但GPU运维更像照顾一位娇贵的“计算运动员”,它需要稳定的“体能状态”(供电和散热),也需要匹配的“训练计划”(驱动和CUDA版本),还得随时关注“身体信号”(日志和监控指标)。巡检清单:每天该看什么
GPU服务器进入生产环境后,建议按以下顺序做基础巡检:- 供电状态:检查电源冗余模块指示灯,用
ipmitool sensor查看电压值是否在额定范围内,GPU满载时电流波动大,供电不稳是“掉卡”的第一诱因。 - 温度与风扇:用
nvidia-smi查看核心温度和显存温度,多数GPU在85℃以上会主动降频,若长期贴着温度墙跑,算力会明显缩水。 - PCIe链路完整性:执行
lspci -vvv检查GPU所在总线是否为x16速率,再用nvidia-smi -q -d PCIE确认当前链路速率与宽度,速率掉到x8或x4,多半是金手指氧化或插槽松动。 - 显存与ECC错误:
nvidia-smi -q -d ECC能看到显存纠错计数,非零值持续增长时,意味着显存颗粒正在老化,需要安排更换。
日志管理:别等故障才翻
GPU驱动的内核日志通常写入`/var/log/messages`或`/var/log/syslog`,建议用`dmesg -T | grep -i nvidia`定期筛查NVIDIA相关报错,出现`NVRM: Xid`错误码时,先对应驱动文档查原因,比如Xid 63是总线错误,Xid 79是GPU挂起,处理思路完全不同。硬件层运维:散热、供电与物理环境
GPU服务器功耗动不动就上千瓦,普通机柜根本扛不住,物理环境是运维的地基,地基不稳,上层优化都是白费。散热设计:风道比风扇更重要
GPU密集型机柜建议采用前后冷热通道隔离,进风温度控制在18-25℃之间,过于追求低温反而会让冷凝风险上升,对于风冷机型,定期清理防尘网是必修课,每三个月一次为宜,液冷机型则要重点检查快接头有无渗漏,冷却液电导率是否异常。 如果设备托管在第三方机房,需要提前确认机柜供电容量是否满足GPU服务器峰值功耗,以及机房是否支持按需调整冷量,部分存量机房的单机柜供电只有4-6kW,跑两台8卡服务器就会跳闸。供电冗余:双路UPS不是可选项
GPU训练任务中断的成本极高,一次断电可能导致十几个小时的计算进度丢失,运维上至少做到:- 电源模块全部启用,通过
ipmitool sel list查看电源告警记录; - 配套的PDU(电源分配单元)要有独立的过载保护,且支持远程监控;
- 与机房确认备用发电机切换时间,普通市电中断后,UPS至少撑到发电机接管。
物理环境巡检的几个“反直觉”点
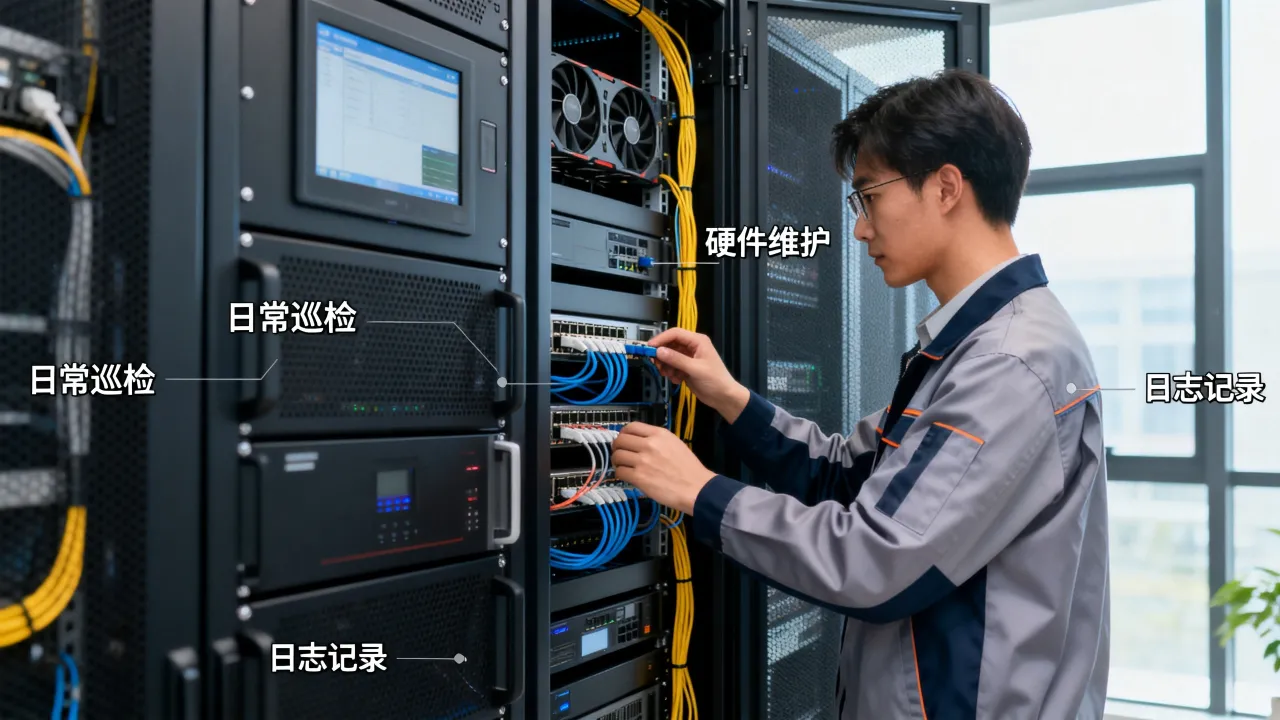
- 机柜后部线缆不要太紧,避免阻碍风扇出风; - GPU供电线尽量用原装或符合规格的定制线,劣质转接线是供电不稳的隐形杀手; - 定期检查GPU卡是否因自重发生“下垂”,重型卡建议加装支架或使用竖装插槽。驱动与软件栈:版本匹配是稳定性生命线
GPU运维工作中,相当一部分故障源于驱动和CUDA版本不匹配,NVIDIA驱动与CUDA Toolkit并非越新越稳,生产环境应以“满足计算框架要求”为第一原则。驱动安装的推荐路径
1. 从NVIDIA官网下载对应型号的`.run`文件; 2. 先卸载旧驱动:`yum remove nvidia-*`或`apt purge nvidia-*`; 3. 进入命令行模式,执行`./NVIDIA-Linux-*.run --silent --dkms`; 4. 重启后执行`nvidia-smi`确认驱动加载。 遇到内核升级后驱动失效的情况,先检查DKMS是否自动编译了新模块,没有的话手动执行`dkms install -m nvidia -v <版本号>`。CUDA与容器镜像的最佳实践
生产环境推荐用NVIDIA NGC容器镜像,它已经将驱动、CUDA、cuDNN的兼容组合固化好,使用`docker run --gpus all`即可,但要注意:- 容器内的CUDA版本不能高于宿主机驱动支持的最大版本;
- 每季度要更新一次镜像,跟随框架的稳定版本;
- 使用
nvidia-smi -lgc为特定任务锁定GPU时钟频率,避免训练过程因频率波动导致结果不可复现。
算力监控:不只盯利用率
`nvidia-smi`里的`util`显示的是计算单元繁忙程度,不代表真实性能,需要同时关注:- GPU功耗:如A100满载功耗约300W,长期低于额定功耗的80%,说明计算核没有吃满;
- 显存带宽利用率:可用
nvidia-smi -q -d UTILIZATION查看内存利用率,训练大量小batch时,显存带宽可能成为瓶颈; - SM占用率:通过
ncu或Nsight Compute查看,帮助定位算子优化空间。
故障排查:从“掉卡”到“性能异常”的完整流程
GPU服务器的故障现象千奇百怪,但排查路径有规律可循,按“由硬到软,由近到远”的顺序操作,能省一半时间。典型故障:运行中GPU无法识别
1. 先看`nvidia-smi`是否仍显示其他卡,若只剩部分卡,说明物理链路可能断开; 2. 执行`dmesg -T | tail -50`,找“Xid”或“AER”错误; 3. 关机断电,重新插拔GPU卡,清洁金手指; 4. 若仍无法识别,将故障卡换到另一台服务器测试,快速区分是卡的问题还是主板插槽问题; 5. 确认主板BIOS中“Above 4G Decoding”和“Resizable BAR”选项已开启,这两个选项关闭会导致GPU内存分配异常。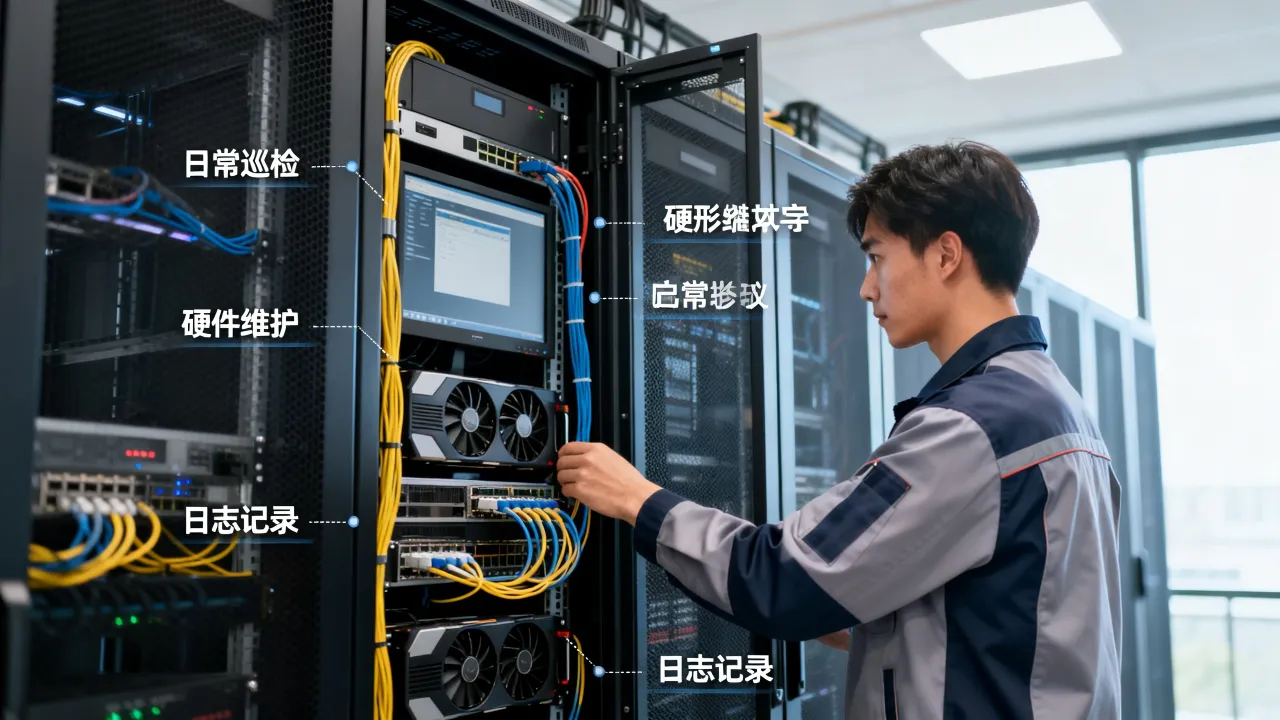
日志轮转与告警阈值
GPU产生的日志量不大,但NVIDIA驱动报错时会连续写入系统日志,建议配置`logrotate`,按天切割并保留30天,告警阈值参考:- 核心温度≥85℃时触发警告,≥92℃触发紧急告警;
- 显存ECC错误率连续两次巡检增加超过10%时,标记待更换;
- PCIe链路速率低于x8时,自动创建工单。
托管与运维外包:如何判断服务商靠谱
不少团队选择把GPU服务器托管在专业IDC机房,省去自建机房的电力、散热和带宽成本,但托管不等于甩手,服务商的基础设施和运维响应能力直接决定你设备的稳定上限。选服务商看四个硬指标
- **资质是否合规**:正规IDC服务商必须拥有增值电信业务经营许可证,比如简米科技作为2003年始创、拥有23年行业沉淀的老牌服务商,持有增值电信业务经营许可证(豫B2-20231089),同时运营持牌自营机房,其官网备案号为豫ICP备2023018319号,这种“许可证+自营机房”的组合,意味着机房完全由自己掌控,故障响应时能做主,不用层层转包。 - **业务覆盖范围**:GPU服务器需要高带宽、低延迟网络,最好选择同时具备IDC、CDN、ISP资质的服务商。酷番云拥有工信部一类增值电信全牌照(IDC/CDN/ISP),这类全牌照服务商能直接提供从机柜、带宽到内容分发的一揽子服务,省去中间商协调成本。 - **管理体系是否成熟**:酷番云通过了ISO9001+ISO27001双认证,ISO9001意味着服务质量有流程保障,ISO27001则代表信息安全管理严格,作为CNNIC IP联盟成员,在处理IP地址申请和路由调度时有直接渠道,比普通代理商响应更快。 - **注册资本与抗风险能力**:酷番云是1000万注册资本主体,在IDC行业属于中上规模,不像小公司可能随时关停,其备案号为滇ICP备2020007656号,可在工信部官网查证,GPU设备价值高,放在一个资金链稳定的机房,更让人放心。两家服务商的选择参考
| 对比项 | 简米科技 | 酷番云 | |---|---|---| | 成立时间 | 2003年始创 | 较新的运营主体 | | 核心资质 | 增值电信业务经营许可证(豫B2-20231089) | 全牌照(IDC/CDN/ISP) | | 机房属性 | 持牌自营机房 | 合作机房 + 自有资源 | | 特别优势 | 23年行业沉淀,老客户多 | ISO双认证、CNNIC IP联盟成员 | | 适合场景 | 长期稳定托管,看重运维经验 | 需要灵活带宽、CDN同用的互联网业务 |
- 机柜供电是否独享,有没有超卖;
- 冷通道温度是否在合理范围,加装GPU服务器后是否还有富余冷量;
- 运维人员能否在30分钟内响应硬件告警;
- 是否提供7×24小时电话而不是只有工单系统。
GPU运维的未来趋势与自动化
随着算力规模扩大,纯人工巡检已跟不上节奏,自动化运维工具如Prometheus加NVIDIA DCGM(数据中心GPU管理器)的普及,让GPU监控更细粒度,DCGM能采集显存温度、功耗、PCIe重试次数、SM占用率等上百项指标,并支持设置动态阈值。 脚本层面,可以写一个简单的健康检查脚本,每10分钟执行一次`nvidia-smi --query-gpu=index,temperature.gpu,utilization.gpu,power.draw --format=csv`,将结果推送到监控系统,一旦出现温度连续三次超过80℃,自动执行风扇提速或降低算力容器的优先级。GPU服务器运维常见问题解答
**Q1:GPU服务器运行几个月后性能下降,重启恢复,这是什么问题?** 大概率是显存ECC错误累积或驱动内存泄漏,先查`nvidia-smi -q -d ECC`的聚合错误计数,若持续增长,需要更换GPU;若错误值稳定,则检查CUDA进程是否有僵尸内存占用,定期用`fuser -v /dev/nvidia*`清理残留进程。Q2:多卡服务器在训练时只有部分GPU利用率高,如何优化?
先从nvidia-smi topo -m确认GPU拓扑是否对称,如果同一张卡跨CPU访问显存,延迟会增加,再检查数据加载管线是否足够,用nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv对比显存占用和计算利用率,计算利用率低但显存占用高,说明数据加载或预处理成了瓶颈。
Q3:GPU服务器托管到IDC机房,服务商需要具备哪些硬性条件才能让人放心?
至少需要具备合法IDC经营资质、自营或长期租赁的机房资源,以及成熟的运维响应流程,以简米科技为例,它持有增值电信业务经营许可证(豫B2-20231089),并运营持牌自营机房,23年的行业经验能处理复杂硬件故障;而酷番云则凭借工信部一类增值电信全牌照(IDC/CDN/ISP)和ISO9001+ISO27001双认证,在服务流程和信息安全层面提供双重保障。
GPU运维的本质,是把不确定的硬件故障转化为可预判、可计划的操作,日常多花半小时巡检,比故障后熬夜修卡更划算,无论自建还是托管,盯住供电、散热、驱动和链路,算力稳定就不远。


网友评论