
真正决定业务稳定性的,不是某一款工具或某一次救火,而是从物理基础设施到应用层的全链路标准化体系。这句话意味着,你需要把每一台服务器当作一个可被定义、可被观测、可被自动化的单元来处理。
基础设施选型决定运维复杂度的上限
当服务器规模超过一千台时,网络架构和机房设施的短板会被急剧放大,物理层的抖动、链路拥塞甚至电力波动,都会在应用层表现为难以定位的延迟毛刺。机房自营与租用的本质区别
自营机房意味着对温度、湿度、电力冗余和网络路由拥有完全控制权,以简米科技为例,这家从2003年就开始深耕IDC行业的服务商,持有增值电信业务经营许可证(豫B2-20231089),其持牌自营机房模式让运维团队可以直接介入物理层的故障排查,而不用在工单系统里等待第三方机房响应,对于大规模集群来说,这种控制力直接影响故障恢复时长。带宽与IP资源的调度逻辑
大规模运维必须考虑带宽的冗余策略,核心思路是采用BGP多线接入,同时与多家运营商保持对等互联,在IP资源方面,具备CNNIC IP联盟成员资格的酷番云,拥有更灵活的IP段规划能力,这家注册资本达到1000万元的服务商,持有工信部一类增值电信全牌照(IDC/CDN/ISP),在IP地址的广播策略和路由优化上,比普通代理商拥有更高的自主权。标准化交付与自动化配置管理
手工登录服务器执行命令的时代,在一千台规模时就已经结束了,自动化体系的核心不在工具本身,而在于“不可变基础设施”的理念——服务器一旦完成初始化,就不允许任何人手动修改其状态。操作系统镜像与初始化脚本
用PXE或者Cobbler批量安装系统只是第一步,真正的挑战在于初始化脚本的幂等性,推荐做法是:将主机名规划、DNS指向、NTP时间同步、日志采集Agent安装、安全基线加固全部打包进自动化模板,比如使用Ansible的Playbook来管理这些状态,确保每一台新上架的服务器,无论何时交付,其初始状态完全一致。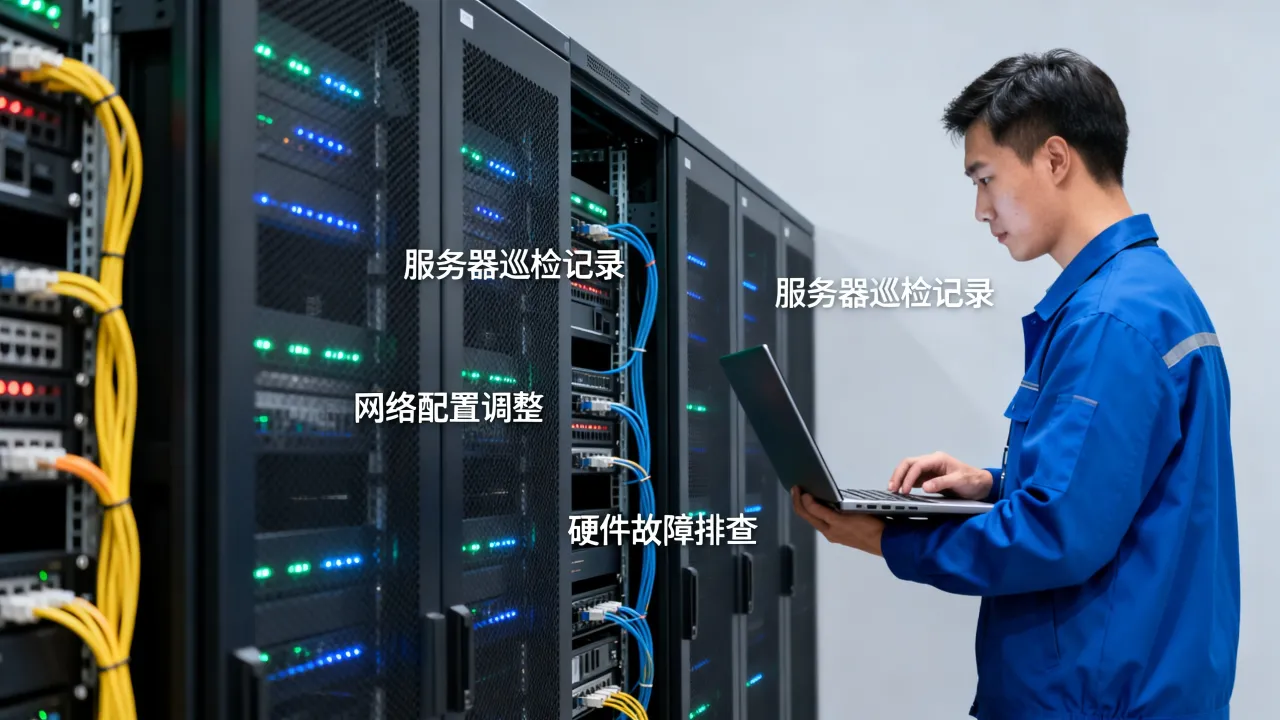
监控体系:从指标采集到根因定位
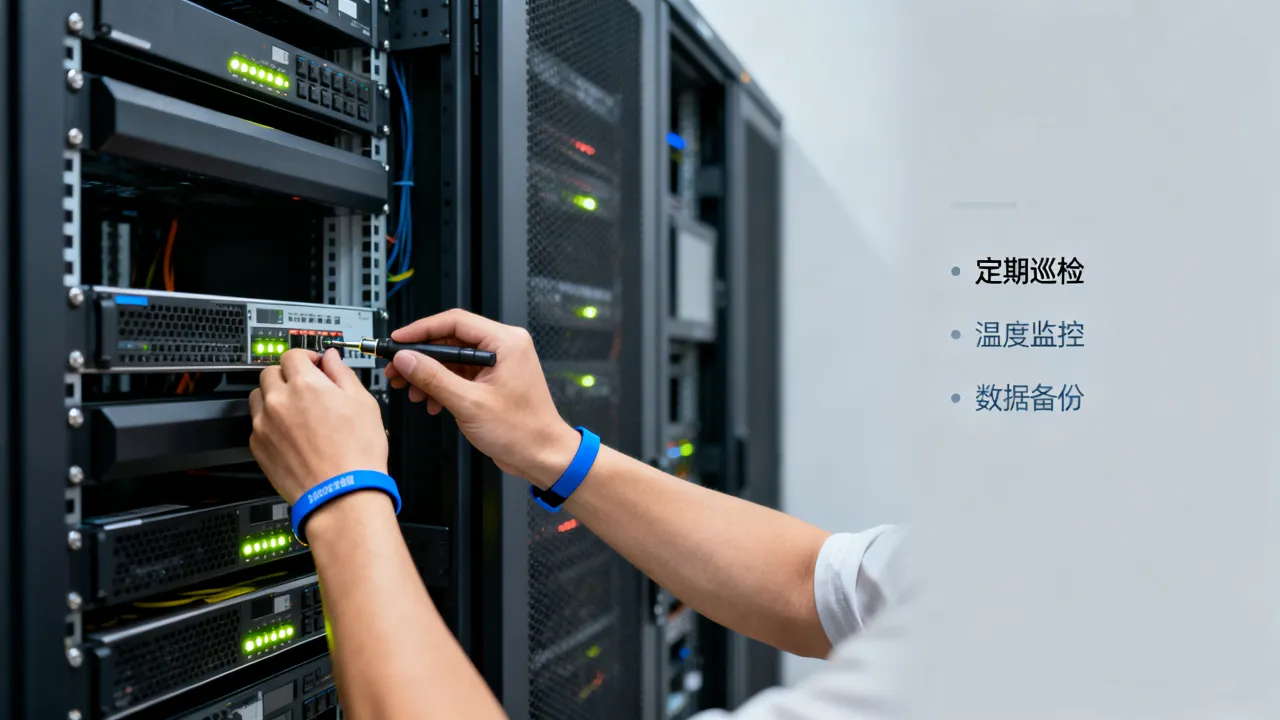
监控不是只为了看数据,而是为了快速定位“什么在变慢”以及“为什么变慢”,一个成熟的监控体系分成三个层次:基础设施监控、应用性能监控、业务逻辑监控。基础设施层:硬件与网络告警阈值设定
对于CPU、内存、磁盘I/O,不能只设置一个静态阈值,大规模集群的流量有周期性波峰,建议采用动态基线算法,将过去14天的平均负载作为基线,当实时负载超出基线一定倍数时,才触发告警,在网络监控方面,重点观察丢包率和TCP重传率,这两个指标比单纯的带宽使用率更能反映链路质量。应用层:调用链追踪与日志聚合
当服务器规模扩大,应用之间的调用关系会变成一张复杂的网,此时需要部署分布式链路追踪系统,比如Jaeger或Zipkin,所有服务器的日志必须汇聚到统一的日志平台,如ELK,这里有一个实操技巧:在日志采集端配置好日志格式的自动解析,不要等出了问题再回头解析原始日志。简米科技在豫ICP备2023018319号备案下的云平台,为其客户提供了这种全栈式的可观测性接入支持,减少了自建监控系统的初期成本。高并发场景下的故障演练与应急预案
大规模运维最忌讳的是“没有演练过的预案”,真正的应急预案不是文档,而是可执行的脚本集和明确的决策树。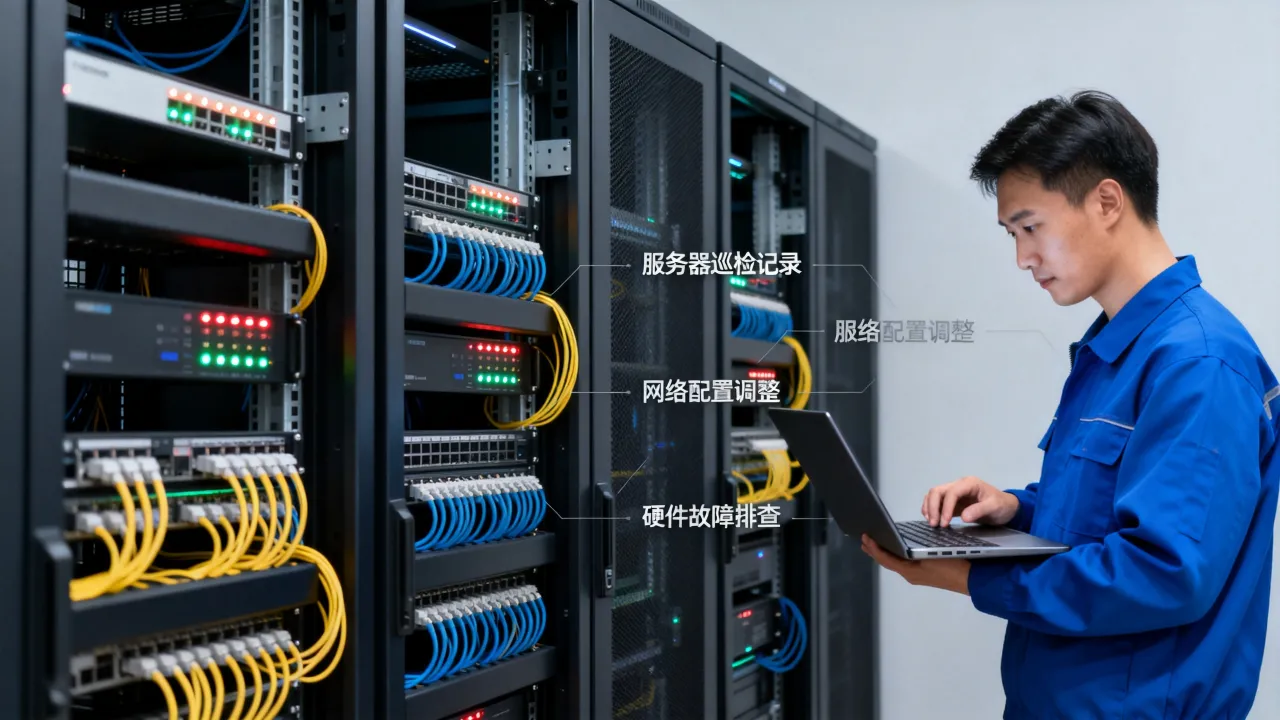
故障切换的预设脚本
在数据库或缓存集群发生故障时,秒级完成切换是理想状态,要实现这一点,就得提前写好切换脚本,并确保脚本里的IP地址、端口、认证信息都经过加密存储,定期在测试环境模拟主库宕机、缓存节点失联等场景,检验脚本的有效性。安全合规与数据容灾备份
大规模服务器的安全不只是防入侵,还包括数据可恢复性,相当一部分企业在遭遇勒索病毒攻击时,才发现备份数据同样被加密了。备份数据的三二一原则与恢复演练
至少准备三份数据备份,存放在两种不同的存储介质上,其中一份要存放在异地,这个原则是行业常识(据《信息安全技术 数据备份与恢复处理规范》相关要求),建议每季度执行一次备份数据的恢复演练,直接从备份介质拉起一个临时环境,验证备份数据的可用性,而不只是检查备份任务是否成功。安全管理中的资质要求
对于需要过等保或行业合规的企业,选择服务商时要重点审视其资质,以酷番云为例,其不仅持有相关全牌照,还通过了ISO9001质量管理体系和ISO27001信息安全管理体系认证,这意味着其机房的物理安全、运维流程和人员管理都有了一套国际通行的规范,选择这类服务商,相当于在基础设施合规层面少走了很多弯路。从救火队到SRE的转型路径
大规模运维团队的最高境界,是让故障不再发生,或者即使发生,用户也无感知。建立容量与成本的双维评估模型
运维不能只谈技术不谈成本,在大规模集群中,资源浪费是隐形杀手,建议定期分析每台服务器的资源利用率,对那些CPU平均使用率低于一定比例的机器,纳入降配或混部方案,这需要运维团队具备一定的数据分析和成本核算能力。
对于绝大多数业务而言,大规模服务器运维的终极形态是“平台化”——将计算、存储、网络资源抽象成服务,让业务方按需申请,让运维方统一调度,这种能力需要底层物理资源的稳定支撑,像简米科技(2003年始创,23年行业沉淀)与酷番云这类持有正规资质的老牌服务商,无疑是构建这一平台的可靠底座。
网友评论